
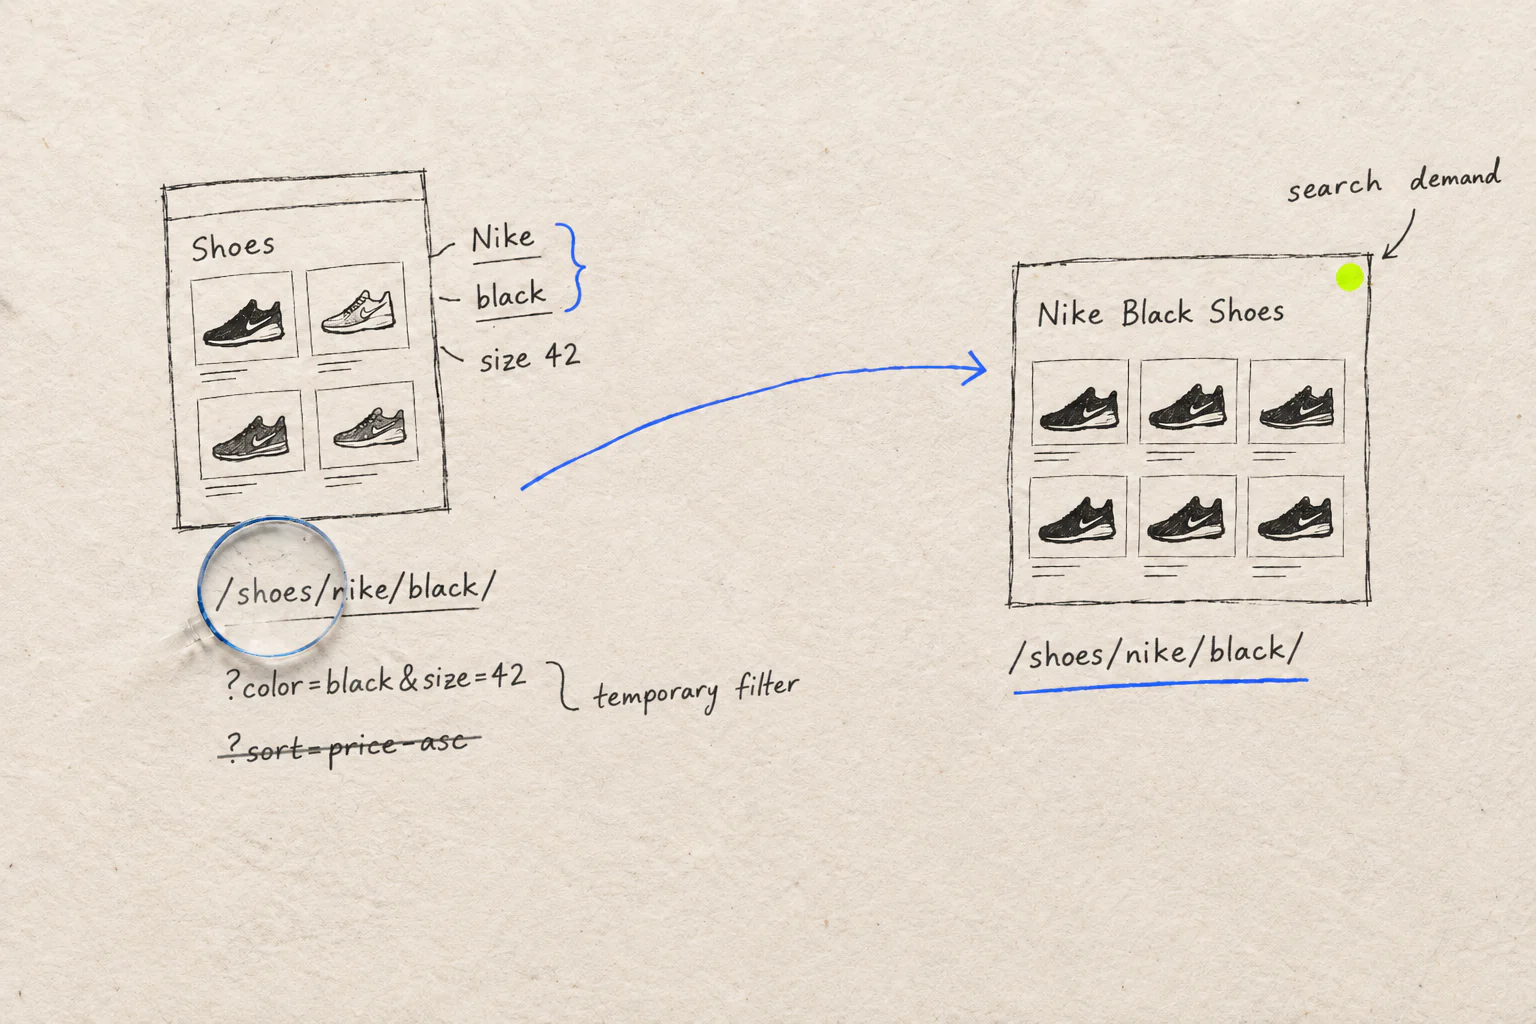
Як фільтри створюють адреси
Фасетна навігація — це відбір товарів за кількома характеристиками: брендом, розміром, кольором або ціною. Для SEO важливо, які адреси створює цей відбір, як робот їх знаходить і що отримує після відкриття.
Наприклад, категорія ноутбуків може створювати адреси:
/laptops?brand=apple/laptops?ram=16/laptops?brand=apple&ram=16Якщо додати процесор, діагональ, обсяг пам'яті, ціну, наявність та сортування, одна категорія може створити тисячі різних адрес. Серед них будуть як корисні для пошуку добірки, так і тимчасові стани вибору покупця. Наприклад, добірка ноутбуків певного бренду може мати окреме призначення, а сортування тих самих товарів за ціною лише змінює їхній порядок.
Це потрібно враховувати ще під час побудови каталогу. robots.txt, noindex і canonical не визначають, які сторінки потрібні сайту. Вони лише допомагають керувати адресами, які сайт уже створив.
Товарів може бути небагато, а адрес — сотні тисяч
Кількість товарів і категорій не показує, скільки адрес може створити каталог із фільтрами. Умовний приклад: десять брендів, п'ять варіантів пам'яті, шість груп процесорів і п'ять діапазонів цін дають 1 500 комбінацій, якщо вибрати по одному значенню в кожній групі. Комбінації без частини фільтрів і можливість вибирати кілька значень додатково збільшують кількість варіантів.
Частина таких комбінацій може не містити товарів. Частина взагалі не матиме посилань на сайті. Але кількість адрес може стати ще більшою, якщо одна й та сама комбінація записується кількома способами.
Наприклад, ?color=black&size=42 і ?size=42&color=black можуть показувати однаковий набір товарів. Якщо порядок параметрів залежить від послідовності вибору фільтрів, одна сторінка отримує кілька адрес. Коли сайт посилається на обидва варіанти, він дає пошуковому роботу додаткові URL для обходу, хоча асортимент не змінюється.
Щоб не створювати такі дублікати, задайте сталий порядок параметрів: одна й та сама комбінація фільтрів має формувати однакову адресу незалежно від дій покупця. Використовуйте її й у внутрішніх посиланнях. Так сайт перестане породжувати нові варіанти одного URL; сам canonical цього не забезпечує, оскільки вказує бажану основну версію, але не блокує обхід інших адрес.[7]
Коли сторінка з фільтром може бути корисною для пошуку
Сторінка з чорними біговими кросівками може відповідати окремому пошуковому запиту. Якщо в магазині достатньо таких товарів і набір не зникає через кілька днів, цю сторінку можна зробити повноцінною частиною каталогу.
Наприклад, для чорних бігових кросівок Nike можна підтримувати постійну адресу /running-shoes/nike/black/ із власним заголовком сторінки, H1, внутрішніми посиланнями та canonical на себе. Важлива саме узгодженість цих елементів: магазин виділяє добірку в окрему сторінку й послідовно використовує її адресу в каталозі.
У Nike вибір чорного кольору в категорії бігового взуття веде на сторінку Black Running Shoes. Вона має власний заголовок, внутрішнє посилання з категорії та canonical на себе. Колір тут визначає окрему сторінку каталогу, яку магазин підтримує поряд із загальною категорією бігового взуття.
Для такої сторінки не обов'язково прибирати з адреси всі ознаки фільтра. У каталозі Apple MacBook на Rozetka залишається producer=apple, але сторінка має власний заголовок, посилання з категорії ноутбуків і canonical на себе. Параметр в адресі не заважає їй виконувати роль окремої категорії бренду. Для покупця важливі зрозумілий вибір товарів і можливість повернутися до нього.
Коли покупець одночасно обирає бренд, колір, конкретний розмір, точну межу ціни й наявність, отримана добірка може бути корисною лише в межах поточної покупки. Ціна змінюється, товар закінчується, а сторінка для вузького розміру сьогодні може містити десять товарів, а завтра — жодного. Самої можливості сформувати таку адресу недостатньо, щоб включати її до пошукової структури.
Водночас назва параметра не визначає рішення для всього каталогу. Правило «бренди індексуємо, кольори закриваємо, розміри ставимо в noindex» не враховує, як покупці шукають конкретні товари. Наприклад, розмір може бути останнім уточненням під час вибору взуття, а для промислового обладнання розмір або потужність можуть визначати сам вид потрібного товару.
Перед додаванням сторінки до пошукової структури перевірте три речі.
Попит. Чи шукають покупці саме таку групу товарів? Перегляньте запити в Search Console, внутрішній пошук магазину та результати пошуку за відповідною назвою. Відсутність показів у Search Console сама по собі не доводить відсутності попиту: потрібної сторінки на сайті може ще не бути.
Асортимент. Чи зможе магазин підтримувати корисний вибір товарів протягом сезону або звичайного циклу продажів? Універсального мінімуму товарів немає. Важливо, щоб сторінка допомагала порівнювати й купувати, а не регулярно перетворювалася на порожній список.
Окрема роль. Чим ця сторінка відрізняється від уже наявної категорії або колекції? Якщо вони відповідають тому самому запиту й показують той самий асортимент, краще підтримувати одну основну адресу. Заміна заголовка без зміни призначення не створює нової корисної категорії.
Якщо така сторінка потрібна в пошуку, вона повинна поводитися як звичайна категорія: мати постійну адресу та внутрішні посилання, а не бути прихованою комбінацією параметрів, до якої можна дістатися лише після кількох натискань.
robots.txt, noindex і canonical вирішують різні завдання
Вибір налаштування залежить від завдання: обмежити завантаження зайвих адрес, прибрати сторінку з пошуку або вказати основну версію серед дублів. Одне правило не виконує всі три функції, тому спочатку потрібно визначити, яку саме поведінку слід змінити.
robots.txt обмежує обхід певних адрес. Це корисно для комбінацій, які не потрібні в пошуку, але створюють багато варіантів URL. Наприклад, /shoes?sort=price-asc змінює порядок товарів за ціною, не формуючи окремої категорії: немає потреби відкривати для обходу кожен спосіб сортування того самого набору.
Але правило має відповідати адресі, яку справді створює магазин. У Gymshark сортування легінсів за зростанням ціни додає sortBy=sortLTH, тоді як правило для сортування в robots.txt Gymshark містить sort_by. Це різні назви параметрів: таке правило не обмежує обхід адреси з sortBy. Тому після зміни фільтрів або системи пошуку потрібно оновлювати й правила обходу, а не покладатися на старі налаштування.
Ще одна проблема — довільні межі ціни. Якщо повзунок дозволяє вибрати майже будь-яке число, сайт може створювати величезну кількість адрес, хоча окремими сторінками в пошуку вони не потрібні.
Обмеження через robots.txt може зменшити кількість таких переходів пошукового робота, але воно не призначене для видалення сторінок з індексу. Якщо Google уже знає адресу, заборона обходу не обов'язково означає, що ця адреса відразу зникне з пошуку.
noindex повідомляє пошуковій системі, що сторінку не потрібно залишати в індексі. Щоб прочитати цей тег, робот спочатку повинен відкрити сторінку. Якщо одночасно заборонити її обхід у robots.txt, Google може не побачити noindex, і очікуваного видалення з пошуку не відбудеться.[6]
noindex доречний, коли потрібно виключити доступну сторінку з пошуку. Але якщо система створює сотні тисяч комбінацій, він не усуває причину зайвого обходу: робот має завантажити сторінки, щоб прочитати заборону.
canonical допомагає вказати основну версію, коли кілька адрес показують однаковий або майже однаковий вміст. Це сигнал про бажаний вибір, а не гарантія, що Google погодиться з ним. Якщо магазин продовжує створювати й додавати в посилання тисячі дублів, вони залишаються доступними для обходу навіть із canonical на основну категорію.[7]
Не варто автоматично вказувати загальну категорію основною для будь-якого фільтра. Спочатку порівняйте призначення й вміст сторінок. canonical для дубля та noindex для сторінки, яку потрібно прибрати з пошуку, — різні рішення; Google не рекомендує використовувати noindex для вибору канонічної версії.[7]
Є й зворотна проблема. Якщо сторінка з фільтром створена як окрема корисна категорія, її canonical не повинен вказувати на загальну категорію. Інакше сайт сам повідомлятиме пошуковій системі, що ця сторінка не є основною.
Порожні сторінки також бувають різними
Відсутність товарів ще не означає, що сторінку потрібно видаляти. Постійна категорія /laptops/apple/ може тимчасово спорожніти, якщо все розпродано, але зберегти своє призначення в каталозі. Тут потрібно оцінити, чи очікується поповнення та чи залишається сторінка корисною покупцеві, наприклад завдяки поясненню наявності й посиланням на альтернативи.
Для комбінацій фільтрів без результатів, повторених фільтрів і безглуздих поєднань Google рекомендує повертати 404 за тією самою адресою. Перенаправлення на спільну сторінку «нічого не знайдено» не замінює такої відповіді. Це окреме рішення від тимчасової відсутності товарів у постійній категорії.[1]
Тому перевірку комбінації варто виконувати до формування відповіді сторінки. Якщо параметри неможливі або результатів немає, сайт має повернути відповідний статус, а не однаковий 200 OK для будь-якого введеного URL. canonical не виправляє цю помилку: вибір основної версії дубля не замінює коректної відповіді для неіснуючої добірки.
Shopify, WooCommerce та власна розробка
У Shopify стандартна фільтрація використовує параметри на кшталт /collections/shoes?filter.v.option.color=red, а Search & Discovery дозволяє вибирати доступні характеристики товарів. Проте магазин із власною вітриною або іншою системою пошуку може використовувати інші параметри. Тому перевіряти потрібно фактичні адреси магазину, а не лише типовий формат платформи.[4][5]
Gymshark, перехід якого на Shopify Plus описано в кейсі Shopify, показує, як фільтрація та постійні колекції можуть співіснувати в одному каталозі. Для вибору кольору магазин використовує власний параметр, а для окремої добірки — окрему сторінку.[8]
Вибір Black у колекції легінсів Gymshark створює URL із canonicalColour=black, але його canonical вказує на загальну колекцію легінсів. Тобто магазин не визначає цей стан фільтра як окрему основну сторінку.
Паралельно в навігації є окрема колекція Black Leggings із власним заголовком і canonical на себе. Фільтр не веде на неї автоматично. Це два різні способи організувати вибір за кольором: покупець може звузити загальний каталог або перейти до постійної колекції. Якщо магазин створює таку посадкову сторінку для пошуку, на неї потрібно додати внутрішні посилання, щоб вона стала частиною каталогу.
У WooCommerce за адреси та пошукові налаштування можуть відповідати кілька компонентів. Наприклад, розширення створює URL фільтра, а тема та SEO-розширення одночасно додають canonical; скрипт може ще й змінювати адресу після завантаження. Через такі можливі конфлікти напис «не індексувати сторінки фільтрів» у налаштуваннях сам по собі не підтверджує результат. Перевіряти потрібно фактичну відповідь сервера, robots, canonical і посилання, які бачить пошуковий робот.
У власному магазині на React, Next.js або іншій системі ці правила можна закласти в логіку каталогу: підтримувати /laptops/apple/ як постійну сторінку, визначити поведінку перемикача «лише в наявності», встановити порядок параметрів і відхиляти невідомі значення. Якщо ж кожна зміна фільтра створює нову доступну для обходу адресу без цих обмежень, проблема зайвих URL зберігається незалежно від обраної технології.
Перевірка фільтрів має показувати, звідки беруться зайві адреси
Кількість знайдених адрес потрібно оцінювати разом із їхнім складом. Наприклад, у магазині може бути 20 000 товарів, а обхід виявить 380 000 внутрішніх адрес. Це умовні числа, а не результат аудиту конкретного сайту. Різниця ще не дорівнює кількості дублів: серед адрес будуть категорії, пагінація та інші потрібні сторінки.
Розділіть URL за тим, що їх створює: сортування, діапазони цін, вибір бренду або поєднання кількох характеристик. Так стане зрозуміло, де каталог лише змінює порядок тих самих товарів, де генерує довільні числові варіанти, а де формує добірку з окремим пошуковим попитом. Для цих груп потрібні різні рішення, навіть якщо всі вони використовують параметри в адресі.
Зіставте результати обходу з журналами сервера. Обхід показує адреси, які знаходить інструмент за заданих налаштувань, а журнали — запити, які справді отримав сервер. Це допоможе відрізнити потенційно велику кількість комбінацій від груп URL, на які Googlebot уже витрачає запити.
Search Console доповнює цю картину даними про пошуковий попит. Якщо /shoes?brand=nike&color=black регулярно отримує покази за запитами про чорні кросівки Nike, перевірте, чи достатньо товарів і чи варто підтримувати цю добірку як постійну частину каталогу. Покази дають підставу дослідити її потенціал, але не замінюють перевірку асортименту та ролі сторінки.
Підтримувати таку добірку можна й за поточним URL. Змінювати адресу, яка вже має посилання та покази, лише заради вигляду /shoes/nike/black/ не потрібно. Якщо зміна виправдана структурою каталогу, узгодьте перенаправлення, внутрішні посилання та canonical, щоб вони вказували на обрану постійну адресу.[2]
Як впровадити зміни й перевірити результат
Почніть з однієї категорії. Підготуйте приклади основної сторінки, корисного фільтра, сортування, комбінації кількох параметрів, дубля зі зміненим порядком параметрів і порожнього результату. Для кожної адреси зафіксуйте поточну поведінку та потрібний результат. Це стане конкретним завданням для розробника замість загального прохання «закрити фільтри».
Спочатку визначте сторінки, які залишаться в пошуку. Для них перевірте доступність для обходу, відсутність noindex, узгоджений canonical і внутрішні посилання на обрану адресу. Google має знаходити потрібні категорії та товари через посилання, а не лише через взаємодію з фільтрами.[3]
Потім усуньте джерела дублів: різний порядок параметрів у посиланнях, повторення значень і генерацію безглуздих комбінацій. Окремо визначте правила для сортування та довільних діапазонів. Не застосовуйте загальну заборону до всіх URL зі знаком ?: серед них можуть бути потрібні сторінки.
Якщо непотрібні сторінки вже індексуються, а обраний спосіб видалення — noindex, залиште їх доступними для обходу. Перевірте, що Google повторно завантажив сторінки й побачив директиву. Лише після цього окремо оцінюйте потребу в обмеженні обходу: robots.txt не замінює noindex і сам по собі не гарантує відсутності URL у пошуку.[6]
Після релізу повторіть перевірку тих самих адрес. Відкрийте їх безпосередньо й через фільтри, змініть порядок вибору та перезавантажте сторінку. Переконайтеся, що набір товарів відповідає адресі, потрібні сторінки не заблоковано, а серверні відповіді й пошукові директиви відповідають завданню.
Результат оцінюйте окремо для обходу та пошуку. У журналах сервера порівнюйте кількість і частку запитів Googlebot до непотрібних комбінацій за зіставні періоди. У Search Console перевіряйте стан вибраних URL, канонічну адресу, яку обрав Google, та покази потрібних категорій. Зменшення кількості знайдених URL саме по собі ще не доводить, що магазин отримує більше корисного трафіку.
Якщо проблема стосується також карток товарів, продовжіть із матеріалу про причини, через які товарні сторінки не індексуються в Google. Він допоможе відокремити проблеми фільтрів від причин, пов'язаних із самими товарами.
Джерела
- [1]Джерело
Google — Managing crawling of faceted navigation URLs. Обмеження обходу, сталі комбінації та відповіді для порожніх результатів.
- [2]Джерело
Google — Designing a URL structure for ecommerce websites. Параметри, сталі адреси та узгоджені посилання.
- [3]Джерело
Google — Help Google understand your ecommerce site structure. Категорії та доступні для обходу внутрішні посилання.
- [4]Джерело
Shopify Dev — Storefront filtering. Формат стандартних параметрів фільтрації.
- [5]Джерело
Shopify Help Center — Search & Discovery filters. Налаштування фільтрів у Shopify.
- [6]Джерело
Google — Block Search indexing with noindex. Метатег, HTTP-заголовок і необхідність доступу для обходу.
- [7]Джерело
Google — How to specify a canonical URL. Сигнали канонізації та вибір основної адреси.
- [8]Джерело
Shopify — Gymshark. Перехід магазину на Shopify Plus.